

Le problème n'est pas un manque de contrôles, mais la difficulté à les relier pour former une seule et même chronologie d'attaque.
Plus je passe de temps sur les déploiements d'IA en entreprise, plus une chose devient évidente : la sécurité de l'IA est incroyablement fragmentée.
Il existe des garde-fous pour LLM, des passerelles d'IA, des outils de sécurité MCP, la sécurité des API, le contrôle des terminaux, le SASE, l'analyse de code et la détection à l'exécution. Chacun résout un problème réel, mais les systèmes agents ne les perçoivent pas comme des couches distinctes, et les attaquants non plus.
Une attaque peut commencer par une requête malveillante, manipuler un modèle, invoquer un outil MCP, atteindre une API en aval, accéder à des données sensibles et, finalement, déclencher une action commerciale réelle. Si chaque contrôle de sécurité ne voit que sa propre partie, l'équipe ne comprend toujours pas ce qui s'est réellement passé.
L'attaque est une seule histoire. La sécurité en voit souvent cinq différentes.
Une attaque, plusieurs couches de sécurité
Prenons un exemple simple parmi les annonces de cette semaine.
Un attaquant utilise une injection de prompt contre un agent de facturation. L'agent compromis appelle de manière répétée une fonction de remboursement exposée via un serveur MCP. Derrière cet outil se trouve une API de remboursement backend, et une faille d'autorisation transforme l'attaque en une exposition d'informations client.
Au niveau du modèle, cela ressemble à une injection de prompt. Au niveau MCP, cela ressemble à une utilisation abusive d'outil. Au niveau de l'API, cela ressemble à un échec d'autorisation. Pour l'entreprise, il s'agit d'un seul et même incident.
Les étiquettes changent selon l'outil de sécurité que vous consultez. L'attaque, elle, ne change pas.
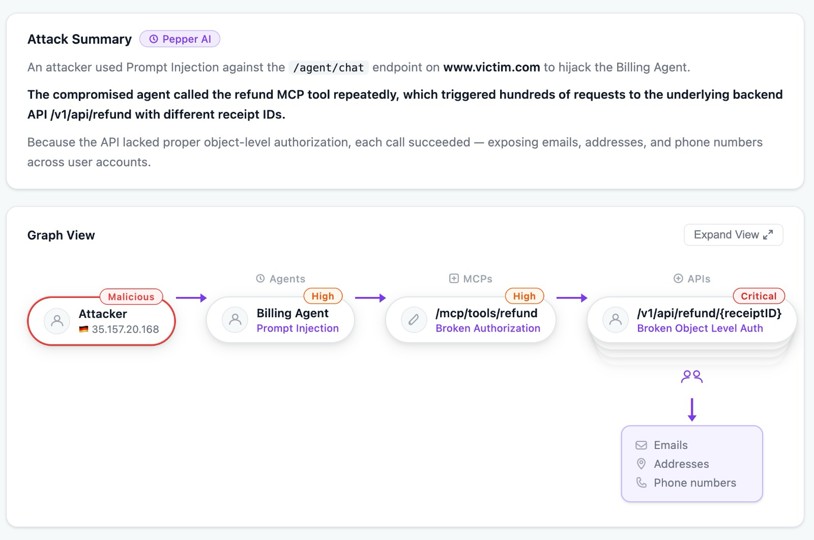
C'est pourquoi le contexte est si crucial dans la sécurité des agents. Vous devez savoir non seulement que le modèle a été manipulé, mais aussi ce que ce modèle pouvait atteindre, quels outils ont été invoqués, quelles API se trouvaient derrière ces outils, quelles données ont été exposées et quelle action a finalement été entreprise.
Sans ce contexte, nous ne faisons que générer davantage d'alertes.
Combler le fossé au niveau du modèle
Aujourd'hui, Salt annonce sa solution native de détection et de réponse IA, ou AI-DR, dans le cadre de notre Plateforme de sécurité des agents. Elle ajoute une protection LLM en temps réel contre les injections de prompt directes et indirectes, les tentatives de jailbreak, les comportements de modèle non sécurisés et d'autres menaces à l'exécution.
Mais pour moi, le point le plus important est ce qui se passe ensuite.
Nous disposions déjà du graphe de sécurité des agents reliant les agents aux serveurs MCP, aux outils, aux API en aval, aux données, à la posture et au comportement à l'exécution. La solution native AI-DR comble la dernière lacune majeure à l'exécution en étendant cette protection à la couche LLM elle-même.
Désormais, les équipes de sécurité peuvent relier les événements survenus au niveau du modèle à leurs conséquences sur l'agent, le MCP, l'API et le système métier, plutôt que d'enquêter sur chaque couche comme un incident isolé.
Injection de prompt → agent compromis → outil MCP → API backend → impact métier
Un seul chemin d'attaque, pas cinq alertes déconnectées.
La sécurité des agents est un problème de corrélation
Protéger le modèle est important. Protéger le MCP est important. Protéger les API est important. Mais aucun de ces éléments ne répond à la question qui préoccupe réellement les équipes de sécurité : que peut atteindre cet agent, que s'est-il passé et quel système métier est désormais en danger ?
Cela exige à la fois de l'étendue et de la profondeur. L'étendue signifie visualiser l'intégralité du parcours de l'agent à travers les modèles, les agents, les serveurs MCP, les outils, les API, les applications, les données et les actions. La profondeur signifie comprendre chaque composant dans son contexte, y compris l'exposition, le code source, la configuration, les autorisations, les données sensibles et le comportement à l'exécution.
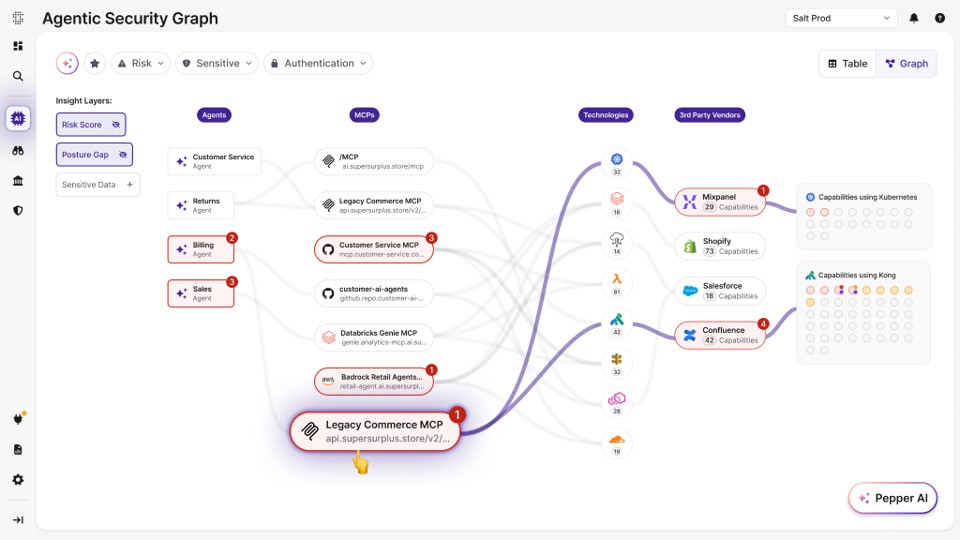
C'est précisément cette combinaison que le Graphe de sécurité des agents est conçu pour offrir. L'objectif n'est pas d'ajouter un énième contrôle de sécurité IA isolé, mais d'apporter une vision connectée de l'environnement et du chemin d'attaque.
Le manque de visibilité actuel est considérable. Dans notre enquête État de l'IA agentique et de la sécurité des APIdu second semestre 2026, 49,8 % des organisations ont déclaré avoir confirmé ou suspecté qu'un agent IA avait effectué une action non intentionnelle, imprévue ou non autorisée au cours de l'année écoulée. Seules 12,5 % ont affirmé être capables de retracer systématiquement le chemin complet, depuis le prompt initial jusqu'aux serveurs MCP et aux API sollicités par l'agent.
C'est ce fossé qui m'inquiète.
Gardez ce qui fonctionne. Connectez ce qui manque.
Les entreprises disposent déjà de protections pour l'IA. Certaines utilisent des garde-fous cloud, d'autres des passerelles IA, tandis que certaines s'appuient sur des contrôles de terminaux ou SASE, sans oublier les plateformes d'IA gérées qui intègrent leurs propres protections. Ces investissements doivent être préservés.
Le problème réside dans le manque d'homogénéité. Un agent peut être protégé par une passerelle IA, tandis qu'un autre, développé en interne et exécuté sur Kubernetes, ne bénéficie d'aucun contrôle équivalent. Les équipes de sécurité doivent savoir ce qui est protégé, ce qui ne l'est pas, et comment tout cela s'articule.
C'est l'approche que nous adoptons. Salt intègre les garde-fous et passerelles existants dans le Graphe de sécurité des agents, tandis que notre solution native AI-DR assure la protection là où elle fait défaut. Nos clients peuvent conserver l'infrastructure et les produits de sécurité qu'ils utilisent déjà.
L'objectif final est le contexte
Cette annonce est importante pour moi car elle comble la dernière lacune majeure en matière d'exécution. Nous pouvons désormais relier ce qui se passe au niveau du modèle à ce qui suit à travers les agents, les MCP, les API, les données et les systèmes métier.
La sécurité de l'IA continuera de générer des contrôles de plus en plus spécialisés, dont beaucoup seront utiles. Mais si ces contrôles restent isolés, les équipes de sécurité devront toujours reconstituer les attaques à partir de fragments.
Une attaque contre un modèle d'IA peut se transformer en attaque contre les systèmes qui font tourner l'entreprise. La sécurité doit avoir une vision globale du parcours.
Vous voulez savoir exactement ce que vos agents IA peuvent atteindre et où se situent les failles ? Découvrez la plateforme de sécurité agentique de Salt ou demandez une démo pour voir votre graphe de sécurité agentique en action.